VPS Pro 1
1 vCPU · 2 Go de mémoire · 20 Go NVMe
Pour un agent personnel, un robot conversationnel ou quelques automatisations.
6,99 $ CA/mois
Payé à l'année : 76,89 $ CA, un mois gratuit
Version gérée : + 21 $ CA par mois
VPS IA
Avec le VPS IA de Simafri, vos agents, vos flux automatisés et vos applications d'IA restent en ligne sans interruption, sur processeurs Intel Xeon et SSD NVMe. Un expert en intelligence artificielle l'a conçu et y héberge ses propres agents. L'Assistance intégrale est incluse : à chaque question, un diagnostic et des consignes claires.
Conçu par un expert en IA
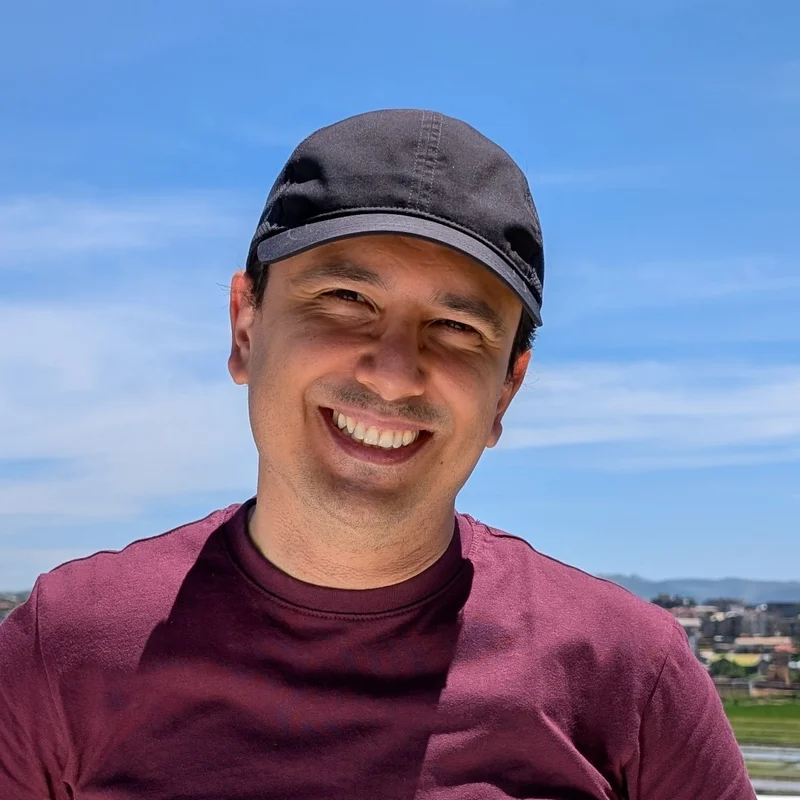
Je m'appelle Simon Vasconcelos Lee. Je conçois des sites web depuis 2002, et les systèmes d'intelligence artificielle sont mon champ d'étude depuis que TensorFlow a été rendu public, en 2015.
Mes agents restent actifs jour et nuit sur nos serveurs, de même que l'assistant IA qui m'épaule chaque jour en développement. C'est donc en partant de leurs besoins réels que j'ai conçu le VPS IA : demeurer en ligne sans coupure, tenir leurs clés d'API en lieu sûr, capter leurs webhooks en HTTPS et récupérer leur mémoire à chaque redémarrage.
Les miens demandent une grosse configuration. La plupart des projets, eux, partent du bon pied avec l'une des trois tailles présentées plus bas, et le serveur grandit avec eux par la suite.
Le site personnel de Simon Vasconcelos LeeVos projets
Votre agent d'IA travaille même pendant votre sommeil : il a besoin d'un serveur qui reste allumé en tout temps. Voici ce que nos clients y mettent en place.
OpenClaw et les agents du même genre vous répondent sur WhatsApp, Telegram ou Slack, font le tri dans vos courriels et lancent des tâches à votre place. Installés sur le VPS IA, ils demeurent joignables même quand votre ordinateur est fermé.
Chaque formulaire rempli, chaque facture reçue, chaque message qui entre : vos flux de travail sollicitent un modèle d'IA, lancés par un webhook ou à une heure précise.
Sur Telegram, Discord ou WhatsApp Business, un assistant répond à votre clientèle de jour comme de nuit, avec le ton et les renseignements propres à votre entreprise.
Votre application Next.js, FastAPI ou Laravel fait appel aux modèles d'Anthropic, d'OpenAI, de Google ou de Mistral, et conserve chez vous ses comptes d'utilisateurs, sa base de données et ses fichiers.
Avec PostgreSQL et pgvector, vos documents sont classés sous forme de vecteurs : avant de répondre, votre assistant repère le passage pertinent dans vos données à vous.
Avec Ollama ou llama.cpp, le processeur exécute des modèles qui calculent des embeddings, classent ou résument, pour des traitements en arrière-plan à coût fixe.
Tarifs
Le VPS IA, c'est un VPS Pro préparé pour l'IA, avec l'accès root, une sauvegarde toutes les nuits, une surveillance en continu et l'Assistance intégrale. Choisissez la taille qui correspond à votre charge ; quand le projet prend de l'ampleur, le serveur passe à la taille suivante en gardant vos données.
1 vCPU · 2 Go de mémoire · 20 Go NVMe
Pour un agent personnel, un robot conversationnel ou quelques automatisations.
6,99 $ CA/mois
Payé à l'année : 76,89 $ CA, un mois gratuit
Version gérée : + 21 $ CA par mois
2 vCPU · 4 Go de mémoire · 50 Go NVMe
Pour n8n et ses flux de travail, un agent qui pilote un navigateur, ou une première application d'IA.
12,49 $ CA/mois
Payé à l'année : 137,39 $ CA, un mois gratuit
Version gérée : + 35 $ CA par mois
2 vCPU · 6 Go de mémoire · 80 Go NVMe
Pour une application d'IA appuyée sur PostgreSQL et pgvector, ou un modèle compact installé sur le serveur.
20,99 $ CA/mois
Payé à l'année : 230,89 $ CA, un mois gratuit
Version gérée : + 49 $ CA par mois
Prix mensuels, taxes en sus. Vous prévoyez d'installer sur le serveur un modèle d'au moins 7 milliards de paramètres ? Les tailles Pro 4 à Pro 6 vous attendent sur la page du VPS Pro.
Prêt pour l'IA
Notre surveillance ne prend jamais congé : votre agent répond la nuit, la fin de semaine et pendant vos vacances.
Vos clés se trouvent sur un serveur dont vous êtes le seul administrateur, accessible en SSH par un port qui lui est réservé et protégé jour et nuit par un filtrage anti-DDoS.
WhatsApp, Telegram, Stripe ou GitHub atteignent votre agent à une adresse HTTPS ; nous nous chargeons d'émettre et de renouveler son certificat.
Un résumé au réveil, un rappel en fin de journée : cron et systemd lancent vos agents à l'heure prévue, sur un serveur toujours éveillé.
Docker, Node.js, Python, PostgreSQL : installez ce dont votre agent a besoin, dans la version exacte qu'il exige.
Historique des conversations, base vectorielle, configuration : chaque nuit, le serveur au complet est copié, chiffré et envoyé à l'extérieur de la machine, et nos équipes le restaurent quand vous le demandez.
Assistance intégrale
L'Assistance intégrale fait partie de chaque VPS IA. Expliquez-nous ce qui se passe, sur le serveur ou dans votre agent : nous remontons jusqu'à la cause, puis nous vous transmettons les étapes à suivre, que vous appliquez vous-même ou que vous confiez à votre assistant IA.
Mon agent cesse de fonctionner quand je quitte ma session SSH.
Nous vous montrons comment l'installer comme service, à l'aide de systemd ou de Docker, pour qu'il reparte de lui-même après une panne ou une mise à jour.
Mon automatisation ne reçoit pas les webhooks de WhatsApp.
Ensemble, nous passons en revue l'adresse publique, le certificat et le mandataire (proxy), puis nous vous indiquons le réglage manquant.
Depuis l'ajout de la recherche vectorielle, mon serveur manque de mémoire.
Nous mesurons la place que prennent les vecteurs et leur index, puis nous vous recommandons le bon réglage ou la bonne taille.
Comment garder mes clés d'API en sécurité ?
Nous vous expliquons où les conserver, comment en limiter l'accès et quels ports de votre serveur il vaut mieux fermer.
Vous aimez mieux laisser le serveur entre nos mains ? Avec le VPS géré, nous en prenons les commandes et suivons votre agent de façon proactive. Découvrir le VPS géré
Fiche technique
Vos VPS IA fonctionnent sur le même matériel que nos serveurs de production, sélectionné pour travailler sans arrêt.
Sur un VPS pour IA, on exécute avant tout du code qui interroge un modèle. Dans la plupart des projets, ce modèle est hébergé chez son éditeur et accessible par une API : votre serveur formule la requête, attend la réponse, puis passe à l'action. Comme le processeur a peu à faire, un Pro 1 ou un Pro 2 fait déjà fonctionner un agent complet.
Installer le modèle directement sur le serveur, c'est garder vos données chez vous et payer un coût fixe, peu importe le volume de requêtes. Les modèles compacts fonctionnent très bien sur processeur : embeddings, classement de messages, résumés de documents traités en arrière-plan. Pour dimensionner votre projet, consultez quel VPS pour faire tourner une IA, le guide où nous détaillons la mémoire qu'occupent les modèles courants.
Sur un portable, un agent s'endort dès que vous refermez l'écran et rate ses webhooks chaque fois que le Wi-Fi lâche. Sur un VPS IA, il a sa propre adresse publique, un certificat HTTPS, une sauvegarde toutes les nuits et une surveillance en continu : il est à l'œuvre à toute heure, et chacune de ses actions reste sous votre contrôle.
Questions fréquentes
Un serveur privé, allumé en tout temps, qui héberge vos agents d'IA, vos flux automatisés et vos applications d'intelligence artificielle. Le VPS IA de Simafri regroupe trois tailles du VPS Pro : processeurs Intel Xeon, mémoire ECC, disques NVMe et Assistance intégrale comprise.
Un agent qui interroge un modèle par API fonctionne très bien sans elle : les calculs se font du côté de l'éditeur du modèle, et votre serveur coordonne le tout. Le processeur du VPS IA prend aussi en charge les modèles compacts, pour les embeddings, le classement ou les résumés en arrière-plan.
Oui. Grâce à l'accès root, l'installation se fait comme sur votre ordinateur, et votre agent reste branché à vos messageries jour et nuit. Dès qu'il pilote un navigateur, qui demande beaucoup de mémoire, nous vous conseillons le Pro 2.
Oui, avec Docker ou Node.js. Vos flux de travail reçoivent leurs webhooks en HTTPS et font appel aux modèles d'IA que vous choisissez. Pour n8n et sa base PostgreSQL, prévoyez le Pro 2.
Oui : elles demeurent sur votre serveur, que vous êtes seul à administrer. La connexion passe par SSH, sur un port réservé à votre VPS ; un filtrage anti-DDoS veille en tout temps, et l'Assistance intégrale vous guide pour bien conserver vos clés et fermer les bons ports.
Oui, avec les modèles compacts. Quantifié en 4 bits, un modèle compris entre un et trois milliards de paramètres prend un à deux gigaoctets de mémoire et loge sans peine sur un Pro 3, aux côtés de votre application. À partir de 7 ou 8 milliards de paramètres, optez pour un Pro 4 ou une taille supérieure.
Pour un agent personnel, un robot conversationnel ou quelques automatisations, prenez le Pro 1. Le Pro 2 convient à n8n ou à un agent qui pilote un navigateur, et le Pro 3 à une application dotée de sa base vectorielle ou à un modèle compact. Vous passez à la taille suivante au moment de votre choix, sans rien perdre de vos données.
Oui. Dès 27,99 $ CA par mois sur le Pro 1, nous nous occupons du serveur et suivons votre agent de façon proactive : nous repérons ce qui s'annonce et vous transmettons nos recommandations avant que le moindre problème devienne visible.
C'est Simon Vasconcelos Lee, le fondateur de Simafri. Expert en intelligence artificielle, il héberge ses propres agents sur nos serveurs.
Expliquez-nous ce que votre agent doit accomplir : nous choisissons sa taille avec vous, puis nous mettons votre serveur en service.
VPS IA
Parlons de votre agent
Dites-nous en deux mots votre projet : on revient vers vous rapidement.
Merci ! Votre demande a bien été envoyée. Nous vous répondrons rapidement.
Vous préférez l'email ? Écrivez-nous à support@simafri.com.